Foto kepada avatar bertutur: setiap foto mendapat suara
Halangan terbesar penghasilan video ialah kamera. Avatar bertutur menghapusnya: muat naik satu potret, lampirkan klip suara, dan AI menggerakkan bibir mengikut audio — kelipan semula jadi, gerakan kepala. Anda tidak perlu lagi muncul di hadapan kamera.
Pendekatan rujukan membalik logik. Anda tunjukkan kepada model muka siapa yang dianimasikan (potret anda, maskot, pengacara) dan suara apa yang digunakan (klip rujukan suara). Model menempel gerakan bercakap pada identiti yang terkunci, bukan mencipta orang baru.
Cuba: penjana avatar bertutur
Log masuk dengan Google dalam 1 saat — daftar masuk setiap hari untuk kredit percuma (sehingga 60 seminggu)Apa yang boleh dilakukan secara percuma →
Demo Pilihan & Prompt Contoh
Klik «Jana dengan prompt ini» untuk mengisi penjana di atas secara automatik
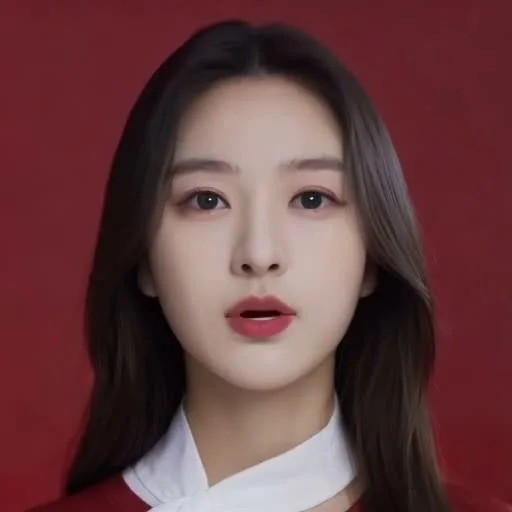
Penyampai Produk E-Dagang
Penyampai wanita profesional bercakap terus ke kamera menerangkan produk, kelipan semula jadi, gerakan kepala halus, cahaya studio hangat
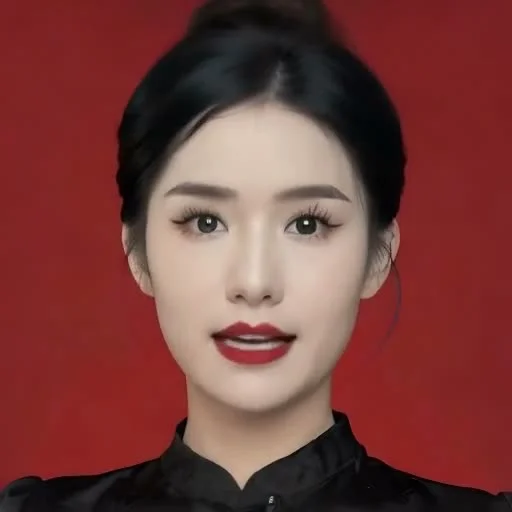
Pengacara Pelancaran & Jenama
Pengacara elegan dengan mikrofon memperkenalkan konsep jenama ke kamera, senyuman yakin, hubungan mata semula jadi dan bibir selari suara
Mengapa avatar bertutur berkesan (bagaimana foto + suara menjadi video)
Sebab nombor satu kreator tidak menerbitkan video ialah kamera. Di hadapan lensa, hafal skrip, rakam semula — berjam-jam. Avatar stok menyelesaikan kamera tetapi muka generik dan bukan suara anda.
Pendekatan rujukan membalik logik. Anda tunjukkan kepada model muka siapa yang dianimasikan (potret anda, maskot, pengacara) dan suara apa yang digunakan (klip rujukan suara). Model menempel gerakan bercakap pada identiti yang terkunci, bukan mencipta orang baru.
Inilah aliran kerja standard untuk live commerce, narasi kursus dan saluran pelbagai bahasa: satu potret yang tidak berubah, satu klip audio setiap bahasa — pengacara yang sama bertutur sepuluh bahasa tanpa rakaman semula.
Cara menghasilkan video avatar bertutur di Sesshu
- STEP 011 / 4
Sediakan satu potret bersih
Foto depan dengan wajah penuh — swafoto, potret AI atau maskot. Satu foto bagi setiap pengacara.
- STEP 022 / 4
Lampirkan foto sebagai rujukan
Dalam penjana di bawah (atau di /reference-to-video), muatkan potret ke panel rujukan.
- STEP 033 / 4
Tambah suara dan tulis skrip
Lampirkan klip suara pendek sebagai rujukan (Kling 4.0 anggapnya suara penceramah), dan fokuskan prompt pada penyampaian — 'bertutur hangat ke kamera, kelipan semula jadi'.
- STEP 044 / 4
Jana dan semak penyampaian
Jana dahulu satu take pendek, semak bibir dan tempo, laraskan skrip atau cahaya, kemudian hasilkan adegan akhir.
Soalan lazim avatar bertutur
Benarkah satu foto boleh jadi video bertutur?
+
Benar. Potret sebagai rujukan, klip audio sebagai suara — model menyesuaikan bibir dan kepala dengan tuturan. Sesshu menyediakannya melalui aliran rujukan suara Kling 4.0.
Audio apa yang boleh digunakan?
+
Klip MP3/WAV pendek sudah cukup: narasi, satu dialog atau rakaman anda sendiri. Kira-kira 15 saat setiap klip, rakam di ruang senyap untuk hasil paling bersih.
Berkesan untuk maskot atau watak kartun?
+
Berkesan — aliran rujukan sama menganimasikan maskot, watak anime dan jurucetak produk. Reka bentuk semakin bersih dan depan, bibir semakin stabil.
Boleh dicuba percuma?
+
Boleh. Kredit percuma daftar masuk harian (6–12 sehari, sehingga 60 seminggu) menampung beberapa take ujian pendek. Tiada kad kredit.