Zdjęcie na mówiący awatar: każde zdjęcie zyskuje głos
Największą barierą w tworzeniu wideo jest kamera. Mówiący awatar ją eliminuje: prześlij portret, dołącz klip głosowy, a AI animuje usta w rytm dźwięku — naturalne mruganie, ruch głowy. Nigdy więcej nie musisz stawać przed obiektywem.
Podejście oparte na referencjach odwraca logikę. Pokazujesz modelowi, czyją twarz animować (Twój portret, maskotka, prezenter) i jakiego głosu użyć (klip referencji głosowej). Model nakłada ruch mówienia na utrwaloną twarz zamiast wymyślać nową osobę.
Wypróbuj: generator mówiących awatarów
Zaloguj się przez Google w 1 sekundę — loguj się codziennie po darmowe kredyty (do 60 tygodniowo)Co możesz za darmo →
Wyróżnione przykłady i prompty
Kliknij „Generuj z tym promptem”, aby automatycznie wypełnić generator powyżej
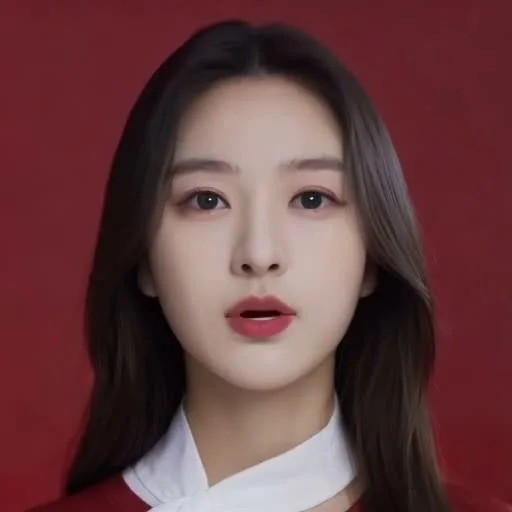
Prezenterka produktów e-commerce
Profesjonalna prezenterka mówi prosto do kamery prezentując produkt, naturalne mruganie i subtelne ruchy głowy, jasne oświetlenie studyjne
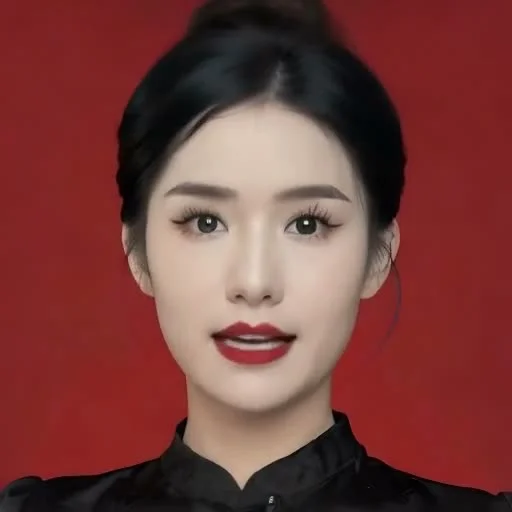
Konferansjerka wydarzeń i marki
Elegancka prowadząca z mikrofonem przedstawia markę przed kamerą, pewny uśmiech, naturalny kontakt wzrokowy i precyzyjny lip-sync
Dlaczego mówiące awatary działają (jak zdjęcie + głos stają się wideo)
Powód numer jeden, dla którego twórcy nie publikują wideo, to kamera. Przed obiektywem, nauka scenariusza, ponowne nagrania — godziny pracy. Stockowe awatary rozwiązują problem kamery, ale mają anonimową twarz i głos, który nie jest Twój.
Podejście oparte na referencjach odwraca logikę. Pokazujesz modelowi, czyją twarz animować (Twój portret, maskotka, prezenter) i jakiego głosu użyć (klip referencji głosowej). Model nakłada ruch mówienia na utrwaloną twarz zamiast wymyślać nową osobę.
To standardowy proces dla live-commerce, narracji kursów i kanałów wielojęzycznych: jeden portret, który się nie zmienia, i klip audio na każdy język — ten sam prezenter mówi w dziesięciu językach bez ponownych nagrań.
Jak stworzyć wideo z mówiącym awatarem w Sesshu
- STEP 011 / 4
Przygotuj czysty portret
Zdjęcie z przodu z widoczną całą twarzą — selfie, portret AI lub maskotka. Jedno zdjęcie na prezentera.
- STEP 022 / 4
Załącz zdjęcie jako referencję
W generatorze poniżej (lub na /reference-to-video) wczytaj portret do panelu referencji.
- STEP 033 / 4
Dodaj głos i napisz tekst
Załącz krótki klip głosowy jako referencję (Kling 4.0 traktuje go jako głos mówcy), a prompt skup na sposobie mówienia — 'mówi ciepło do kamery, naturalne mruganie'.
- STEP 044 / 4
Wygeneruj i sprawdź efekty
Najpierw wygeneruj krótkie ujęcie, sprawdź usta i tempo, popraw tekst lub światło, potem wygeneruj sceny finałowe.
FAQ mówiących awatarów
Czy zdjęcie naprawdę staje się mówiącym wideo?
+
Tak. Portret jako referencja, klip audio jako głos — model dopasowuje usta i głowę do mowy. Sesshu wspiera to przez referencję głosową Kling 4.0.
Jakich audio mogę użyć?
+
Wystarczy krótki klip MP3/WAV: narracja, kwestia lub Twoje nagranie. Około 15 sekund na klip, najlepiej nagrany w cichym pomieszczeniu.
Czy działa z maskotkami i postaciami z kreskówek?
+
Tak — ten sam proces animuje maskotki, postacie anime i twarze produktów. Im czystszy i bardziej frontalny design, tym stabilniejsze usta.
Czy można wypróbować za darmo?
+
Tak. Darmowe kredyty z check-inu (6–12 dziennie, do 60 tygodniowo) wystarczą na kilka testowych ujęć. Karta nie jest wymagana.