照片数字人:让任意照片开口说话
内容创作中最难的一步是“自己出镜”。口播数字人直接绕过它:上传一张正面人像,附上一段语音参考,AI 就会为这张脸生成说话动作——口型跟随音频、自然眨眼、头部微动——而你始终不必面对镜头。
参考图工作流改变了这一点:把“要动谁的脸”(你的人像、吉祥物、主播形象)和“用什么声音”(语音参考片段)直接展示给模型。模型是在锁定的人物身份之上叠加说话动作,而不是凭空发明一个新人。
立即体验:照片转口播数字人
Google 一秒登录,每天签到领积分(每周最多 60 积分)免费能做的事 →
精选效果展示与提示词
点击「用此提示词生成」可自动载入上方生成器,即刻复现效果
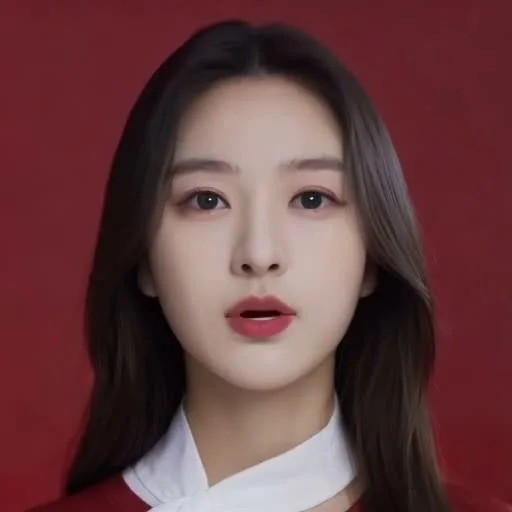
电商带货与产品讲解主播
一位专业女性主播面向镜头讲解产品,神态亲切自然,口型与语音严格对齐,自然的眨眼与头部微动,明亮影棚光,固定机位中景
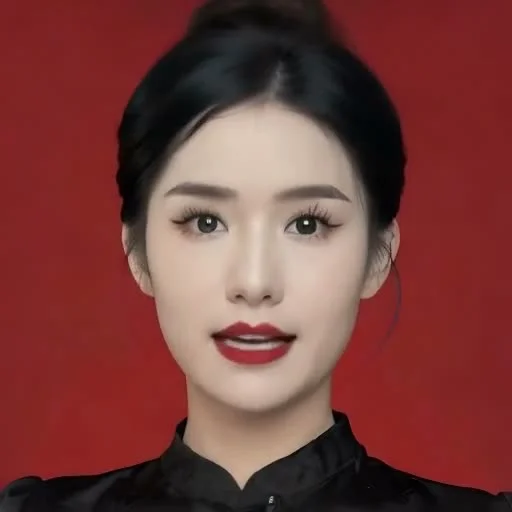
品牌发布会与活动主持人
手持麦克风的女性主持人面向镜头介绍活动流程与品牌理念,自信微笑,自然的眼神交流与唇形同步,纯色专业背景
为什么口播数字人有效(照片+语音如何变成视频)
大多数人做不出视频内容的原因只有一个:镜头。面对镜头、背稿、反复重录动辄几个小时。通用虚拟形象虽然解决了镜头问题,但脸是“路人脸”,声音也不是你自己的。
参考图工作流改变了这一点:把“要动谁的脸”(你的人像、吉祥物、主播形象)和“用什么声音”(语音参考片段)直接展示给模型。模型是在锁定的人物身份之上叠加说话动作,而不是凭空发明一个新人。
这是电商主播、课程讲师、多语言频道的标准工作流:人像保持一张不变,只按语言替换语音片段——同一位主播可以说十种语言,无需重拍。
在 Sesshu 中制作口播数字人视频的 4 个步骤
- STEP 011 / 4
准备一张干净的正面人像
露出完整头部、面向镜头的照片:自拍、AI 肖像或吉祥物设计均可。每位主播一张标准图。
- STEP 022 / 4
将照片挂载为参考图
在下方的生成器中(或前往 /reference-to-video),把人像照片添加到参考资料面板。
- STEP 033 / 4
添加语音并写好口播稿
附上一段短语音作为参考(Kling 4.0 会将其作为说话者的声音),提示词专注描述表达方式——“面对镜头温和地说话,自然眨眼”。
- STEP 044 / 4
生成并检查口播效果
先生成一条短样片,检查口型与节奏;调整台词或灯光描述后,再批量生成正式镜头。
口播数字人常见问题
一张照片真的能变成会说话的视频吗?
+
可以。把人像作为参考图、语音片段作为说话者的声音传入,模型就会让口型与头部动作贴合表达。Sesshu 通过 Kling 4.0 的声質参考工作流支持这一玩法。
可以用什么音频当声音?
+
一段短 MP3/WAV 即可:解说、台词或你自己的录音。每条约控制在 15 秒以内,并在安静房间录音效果最干净。
卡通形象、吉祥物也能开口吗?
+
可以。同样的参考工作流适用于吉祥物、动漫角色和产品代言人。设计越正面、越干净,口型越稳定。
可以免费试用吗?
+
可以。每日签到免费积分(每天 6–12,每周最高 60)足够完成几次短样片测试。无需绑定信用卡。