照片數位人:讓任意照片開口說話
內容創作中最難的一步是「自己出鏡」。口播數位人直接繞過它:上傳一張正面人像,附上一段語音參考,AI 就會為這張臉生成說話動作——口型跟隨音訊、自然眨眼、頭部微動——而你始終不必面對鏡頭。
參考圖工作流改變了這一點:把「要動誰的臉」(你的人像、吉祥物、主播形象)和「用什麼聲音」(語音參考片段)直接展示給模型。模型是在鎖定的人物身份之上疊加說話動作,而不是憑空發明一個新人。
立即體驗:照片轉口播數位人
Google 一秒登入,每天簽到領點數(每週最多 60 點數)免費可以做什麼 →
精選效果展示與提示詞
點擊「用此提示詞生成」可自動載入上方產生器,即刻復現效果
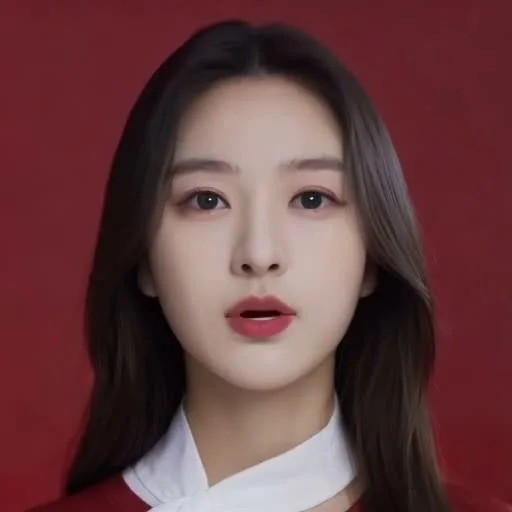
電商帶貨與產品講解主播
一位專業女性主播面向鏡頭講解產品,神態親切自然,口型與語音嚴格對齊,自然的眨眼與頭部微動,明亮攝影棚光,固定機位中景
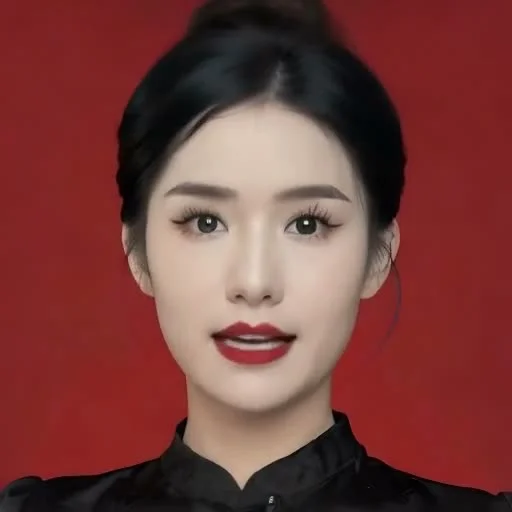
品牌發布會與活動主持人
手持麥克風的女性主持人面向鏡頭介紹活動流程與品牌理念,自信微笑,自然的眼神交流與唇形同步,純色專業背景
為什麼口播數位人有效(照片+語音如何變成影片)
大多數人做不出影片內容的原因只有一個:鏡頭。面對鏡頭、背稿、反覆重錄動輒幾個小時。通用虛擬形象雖然解決了鏡頭問題,但臉是「路人臉」,聲音也不是你自己的。
參考圖工作流改變了這一點:把「要動誰的臉」(你的人像、吉祥物、主播形象)和「用什麼聲音」(語音參考片段)直接展示給模型。模型是在鎖定的人物身份之上疊加說話動作,而不是憑空發明一個新人。
這是電商主播、課程講師、多語言頻道的標準工作流:人像保持一張不變,只按語言替換語音片段——同一位主播可以說十種語言,無需重拍。
在 Sesshu 中製作口播數位人影片的 4 個步驟
- STEP 011 / 4
準備一張乾淨的正面人像
露出完整頭部、面向鏡頭的照片:自拍、AI 肖像或吉祥物設計均可。每位主播一張標準圖。
- STEP 022 / 4
將照片掛載為參考圖
在下方的生成器中(或前往 /reference-to-video),把人像照片新增到參考資料面板。
- STEP 033 / 4
加入語音並寫好口播稿
附上一段短語音作為參考(Kling 4.0 會將其作為說話者的聲音),提示詞專注描述表達方式——「面對鏡頭溫和地說話,自然眨眼」。
- STEP 044 / 4
生成並檢查口播效果
先生成一條短樣片,檢查口型與節奏;調整台詞或燈光描述後,再批次生成正式鏡頭。
口播數位人常見問題
一張照片真的能變成會說話的影片嗎?
+
可以。把人像作為參考圖、語音片段作為說話者的聲音傳入,模型就會讓口型與頭部動作貼合表達。Sesshu 透過 Kling 4.0 的聲質參考工作流支援這一玩法。
可以用什麼音訊當聲音?
+
一段短 MP3/WAV 即可:解說、台詞或你自己的錄音。每條約控制在 15 秒以內,並在安靜房間錄音效果最乾淨。
卡通形象、吉祥物也能開口嗎?
+
可以。同樣的參考工作流適用於吉祥物、動漫角色和產品代言人。設計越正面、越乾淨,口型越穩定。
可以免費試用嗎?
+
可以。每日簽到免費積分(每天 6–12,每週最高 60)足夠完成幾次短樣片測試。無需綁定信用卡。