Фото в говорящий аватар: каждое фото обретает голос
Главный барьер в создании видео — камера. Говорящий аватар убирает его: загрузите портрет, добавьте голосовой клип, и ИИ анимирует губы под аудио — естественные моргания, движения головы. Вам больше никогда не нужно появляться в кадре.
Подход на основе референсов переворачивает логику. Вы показываете модели, чьё лицо анимировать (ваш портрет, маскот, ведущий) и какой голос использовать (голосовой референс-клип). Модель накладывает артикуляцию на зафиксированное лицо, а не придумывает нового человека.
Попробовать: генератор говорящего аватара
Войдите через Google за 1 секунду — ежедневный чек-ин за бесплатные кредиты (до 60 в неделю)Что можно делать бесплатно →
Избранные примеры и промпты
Нажмите «Сгенерировать с этим промптом», чтобы автоматически заполнить генератор выше
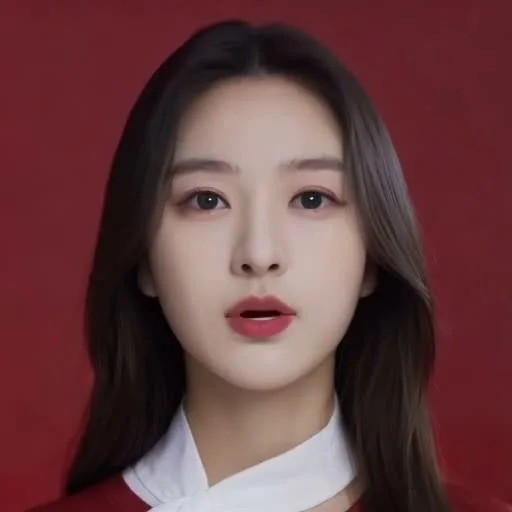
Ведущая для обзоров товаров
Профессиональная ведущая обращается прямо в камеру и представляет продукт, естественное моргание, лёгкие движения головы, мягкий студийный свет
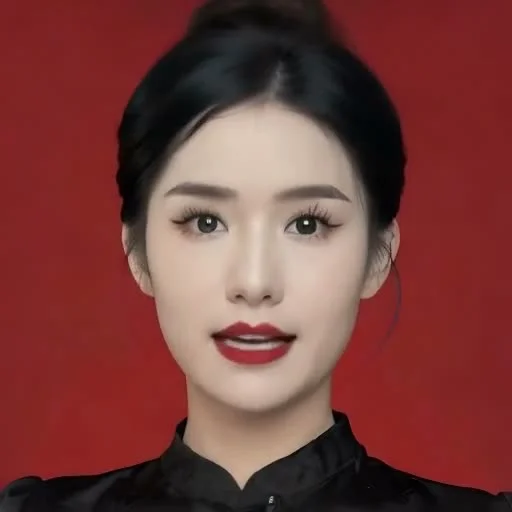
Спикер презентации и бренда
Элегантная ведущая с микрофоном рассказывает о бренде в камеру, уверенная улыбка, живой зрительный контакт и точная синхронизация губ
Почему говорящие аватары работают (как фото + голос становятся видео)
Причина номер один, по которой авторы не публикуют видео, — камера. Перед объективом, заучивание сценария, пересъёмки — часы работы. Стоковые аватары решают проблему камеры, но у них безликое лицо и чужой голос.
Подход на основе референсов переворачивает логику. Вы показываете модели, чьё лицо анимировать (ваш портрет, маскот, ведущий) и какой голос использовать (голосовой референс-клип). Модель накладывает артикуляцию на зафиксированное лицо, а не придумывает нового человека.
Это стандартный процесс для live-коммерции, озвучки курсов и мультиязычных каналов: один портрет, который не меняется, и аудиоклип на каждый язык — один ведущий говорит на десяти языках без пересъёмок.
Как сделать видео с говорящим аватаром в Sesshu
- STEP 011 / 4
Подготовьте чистый портрет
Фронтальное фото с полностью видимым лицом — селфи, ИИ-портрет или маскот. Одно фото на ведущего.
- STEP 022 / 4
Прикрепите фото как референс
В генераторе ниже (или на /reference-to-video) загрузите портрет в панель референсов.
- STEP 033 / 4
Добавьте голос и напишите текст
Прикрепите короткий голосовой клип как референс (Kling 4.0 считает его голосом спикера), а промпт сфокусируйте на подаче — «тепло говорит в камеру, естественные моргания».
- STEP 044 / 4
Сгенерируйте и проверьте подачу
Сначала сделайте короткий дубль, проверьте губы и темп, поправьте текст или свет, затем сгенерируйте финальные сцены.
Частые вопросы о говорящих аватарах
Фото действительно превращается в говорящее видео?
+
Да. Портрет как референс, аудиоклип как голос — модель подстраивает губы и голову под речь. Sesshu поддерживает это через голосовой референс Kling 4.0.
Какие аудио можно использовать?
+
Подойдёт короткий MP3/WAV-клип: закадровый голос, реплика или ваша запись. Около 15 секунд на клип, записывайте в тихой комнате для чистого результата.
Работает ли с мультяшными персонажами и маскотами?
+
Да — тот же процесс анимирует маскотов, аниме-персонажей и талисманов продукта. Чем чище и фронтальнее дизайн, тем стабильнее артикуляция.
Можно попробовать бесплатно?
+
Да. Бесплатных кредитов чек-ина (6–12 в день, до 60 в неделю) хватит на несколько тестовых дублей. Карта не нужна.