사진가 말하게 하는 AI 토킹 아바타
영상 제작에서 가장 어려운 건 '카메라 앞에 서는 것'입니다. 토킹 아바타는 이 장벽을 없앱니다. 인물 사진 1장과 음성 클립을 넣으면 AI가 입 모양을 음성에 맞춰 움직이고, 눈 깜빡임과 고개 움직임도 자연스럽게 만들어 줍니다.
참조 이미지 기반 방식은 다릅니다. '누구의 얼굴을 움직일지'(본인 초상화, 마스코트, 진행자)와 '어떤 목소리를 쓸지'(음성 참조 클립)를 모델에 직접 보여줍니다. 모델은 새 인물을 발명하는 대신 고정된 얼굴 위에 말하기 동작을 얹습니다.
체험하기: 토킹 아바타 생성기
Google로 1초 로그인하고 매일 체크인 (주 최대 60크레딧)무료로 할 수 있는 것 →
엄선된 데모 및 프롬프트 예시
'이 프롬프트로 생성'을 클릭하면 위 생성기에 자동으로 입력됩니다
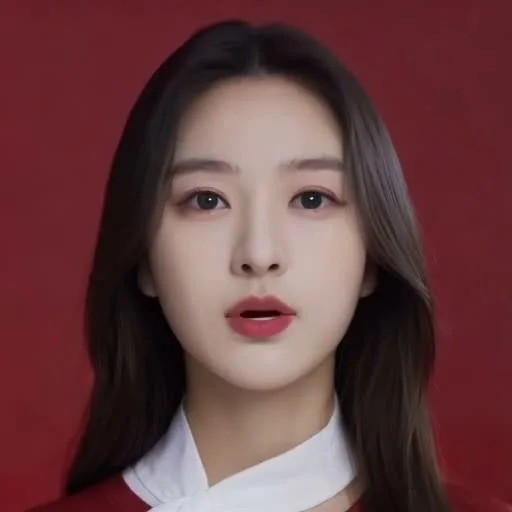
이커머스 제품 소개 쇼호스트
전문 여성 진행자가 카메라를 향해 친근하게 제품을 설명한다. 음성과 정확히 일치하는 입 모양, 자연스러운 눈 깜빡임과 고개 움직임, 밝은 스튜디오 조명
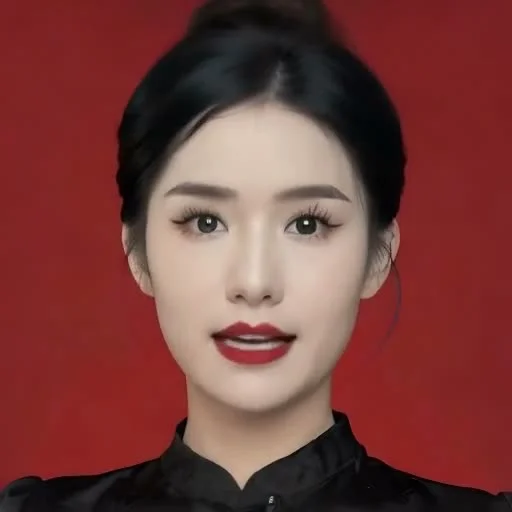
브랜드 키노트 및 행사 MC
마이크를 든 여성 MC가 카메라를 보며 브랜드 콘셉트를 소개한다. 자신감 있는 미소, 자연스러운 아이컨택과 립싱크
토킹 아바타가 효과적인 이유 (사진+음성이 영상이 되는 원리)
대부분의 제작자가 영상을 올리지 못하는 이유는 단 하나, 카메라입니다. 렌즈 앞에서 대본을 외우고 다시 찍는 데 몇 시간이 걸립니다. 스톡 아바타는 카메라 문제를 해결하지만 얼굴이 뻔하고 목소리도 본인 것이 아닙니다.
참조 이미지 기반 방식은 다릅니다. '누구의 얼굴을 움직일지'(본인 초상화, 마스코트, 진행자)와 '어떤 목소리를 쓸지'(음성 참조 클립)를 모델에 직접 보여줍니다. 모델은 새 인물을 발명하는 대신 고정된 얼굴 위에 말하기 동작을 얹습니다.
이커머스 라이브, 강의 내레이션, 다국어 채널의 표준 워크플로우입니다. 초상화는 1장 그대로 두고 언어별로 음성만 바꾸면, 같은 진행자가 10개 언어로 말할 수 있습니다.
Sesshu에서 토킹 아바타 영상을 만드는 4단계
- STEP 011 / 4
깨끗한 정면 사진 준비
머리 전체가 보이는 정면 사진 1장: 셀카, AI 초상화, 마스코트 모두 가능합니다. 진행자당 1장.
- STEP 022 / 4
사진을 참조로 첨부
아래 생성기(또는 /reference-to-video)에서 인물 사진을 참조 패널에 첨부합니다.
- STEP 033 / 4
음성 추가 후 대사 작성
짧은 음성 클립을 참조 음성으로 첨부하고(Kling 4.0은 이를 화자의 목소리로 처리), 프롬프트는 전달 방식에 집중합니다 — '카메라를 향해 따뜻하게 말한다, 자연스러운 눈 깜빡임'.
- STEP 044 / 4
생성 후 전달력 확인
짧은 샘플을 먼저 생성해 입 모양과 템포를 확인하고, 대사나 조명 프롬프트를 조정한 뒤 본 장면을 일괄 생성합니다.
토킹 아바타 자주 묻는 질문
사진 한 장으로 정말 말하는 영상이 만들어지나요?
+
네. 인물 사진을 참조로, 음성 클립을 화자의 목소리로 넣으면 모델이 말하는 방식에 맞춰 입과 고개를 움직입니다. Sesshu는 Kling 4.0 목소리 참조 워크플로우로 지원합니다.
어떤 오디오를 목소리로 쓸 수 있나요?
+
해설, 대사, 본인 녹음 등 짧은 MP3/WAV면 됩니다. 클립당 약 15초 이내로 유지하고 조용한 방에서 녹음하면 가장 깨끗합니다.
캐릭터나 마스코트도 말하게 할 수 있나요?
+
가능합니다. 같은 참조 워크플로우로 마스코트, 애니메이션 캐릭터, 제품 마스코트도 말하게 할 수 있습니다. 정면을 향한 깨끗한 디자인일수록 입 모양이 안정적입니다.
무료로 체험할 수 있나요?
+
네. 매일 체크인 무료 크레딧(하루 6~12, 주 60)으로 짧은 테스트 촬영을 여러 번 할 수 있습니다. 신용카드는 필요 없습니다.