عکس به آواتار سخنگو: هر عکس صدا میگیرد
بزرگترین مانع ساخت ویدیو، دوربین است. آواتار سخنگو آن را حذف میکند: یک پرتره آپلود کنید، یک کلیپ صوتی ضمیمه کنید و هوش مصنوعی لبها را با صدا هماهنگ میکند — پلکزدن طبیعی و حرکت سر. دیگر هرگز لازم نیست جلوی دوربین بایستید.
رویکرد مرجعمحور منطق را وارونه میکند. به مدل نشان میدهید چهره چه کسی را باید متحرک کند (پرتره شما، مسکات، مجری) و از چه صدایی استفاده کند (کلیپ صوتی مرجع). مدل حرکت گفتار را روی آن چهره ثابتشده مینشاند، نه اینکه شخص جدیدی بسازد.
امتحان کنید: سازنده آواتار سخنگو
در ۱ ثانیه با Google وارد شوید — چک-این روزانه، اعتبار رایگان (تا ۶۰ در هفته)چه کارهایی رایگان است؟ →
دموها و پرامپتهای برگزیده
روی «ساخت با این پرامپت» کلیک کنید تا فرم بالا به صورت خودکار پر شود
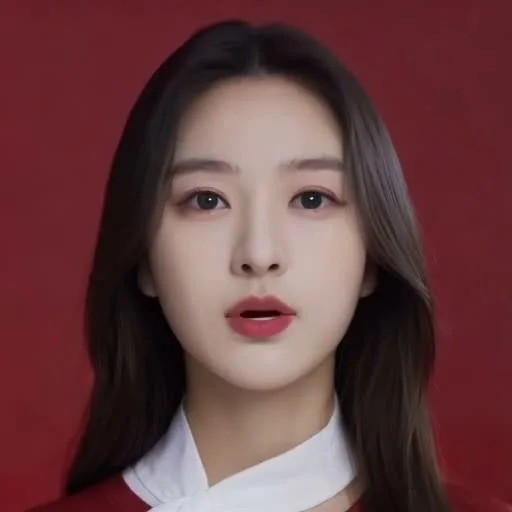
مجری معرفی محصولات فروشگاهی
مجری خانم حرفهای مستقیم رو به دوربین محصول را معرفی میکند، پلک زدن طبیعی، حرکت ملایم سر، نور استودیویی گرم، نمای متوسط ثابت
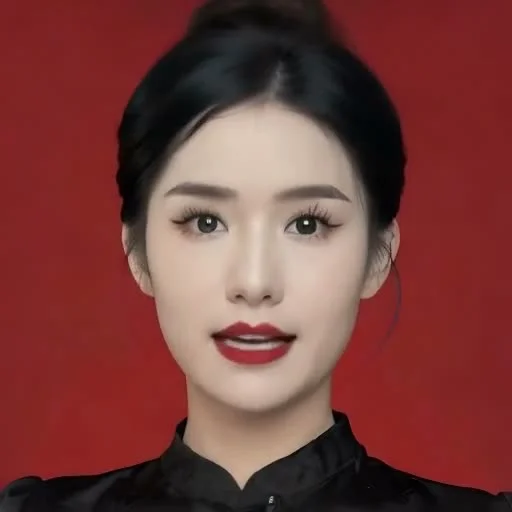
مجری رویداد و معرفی برند
مجری خوشپوش با میکروفون چشمانداز برند را مقابل دوربین معرفی میکند، لبخند مطمئن، تماس چشمی طبیعی و هماهنگی دقیق لبها
چرا آواتارهای سخنگو جواب میدهند (عکس + صوت چگونه ویدیو میشود)
دلیل شماره یک اینکه سازندگان ویدیو منتشر نمیکنند، دوربین است. جلوی لنز، حفظ متن، ضبط دوباره — ساعتها کار. آواتارهای آماده مشکل دوربین را حل میکنند اما چهرهای عمومی و صدایی غیر از صدای شما دارند.
رویکرد مرجعمحور منطق را وارونه میکند. به مدل نشان میدهید چهره چه کسی را باید متحرک کند (پرتره شما، مسکات، مجری) و از چه صدایی استفاده کند (کلیپ صوتی مرجع). مدل حرکت گفتار را روی آن چهره ثابتشده مینشاند، نه اینکه شخص جدیدی بسازد.
این فرایند استاندارد لایوکامرس، گویندگی دورهها و کانالهای چندزبانه است: یک پرتره که تغییر نمیکند و یک کلیپ صوتی برای هر زبان — همان مجری بدون ضبط مجدد به ده زبان حرف میزند.
چگونه در Sesshu ویدیوی آواتار سخنگو بسازیم
- STEP 011 / 4
یک پرتره تمیز آماده کنید
یک عکس روبهرو با چهره کاملاً مشخص — سلفی، پرتره هوش مصنوعی یا مسکات. برای هر مجری یک عکس.
- STEP 022 / 4
عکس را بهعنوان مرجع ضمیمه کنید
در سازنده زیر (یا در /reference-to-video) پرتره را در پنل مراجع بارگذاری کنید.
- STEP 033 / 4
صدا را اضافه و متن را بنویسید
یک کلیپ صوتی کوتاه بهعنوان مرجع ضمیمه کنید (Kling 4.0 آن را صدای گوینده میداند) و پرامپت را روی نحوه ادای کلام متمرکز کنید — «گرم به دوربین حرف میزند، پلکزدن طبیعی».
- STEP 044 / 4
تولید کنید و ادای کلام را بررسی کنید
اول یک نگاه کوتاه تولید کنید، لبها و ریتم را ببینید، متن یا نور را تنظیم کنید و سپس صحنههای نهایی را یکجا بسازید.
پرسشهای متداول آواتار سخنگو
آیا یک عکس واقعاً به ویدیوی سخنگو تبدیل میشود؟
+
بله. پرتره بهعنوان مرجع و کلیپ صوتی بهعنوان صدای گوینده — مدل لب و سر را با گفتار تنظیم میکند. Sesshu این را با جریان مرجع صدای Kling 4.0 ارائه میدهد.
چه فایل صوتی میتوانم استفاده کنم؟
+
یک کلیپ کوتاه MP3/WAV کافی است: گویندگی، یک دیالوگ یا ضبط خودتان. حدود ۱۵ ثانیه برای هر کلیپ و ضبط در اتاق ساکت بهترین نتیجه را میدهد.
برای مسکات و شخصیتهای کارتونی هم جواب میدهد؟
+
بله — همان جریان مرجع، مسکاتها، شخصیتهای انیمه و سفیران محصول را متحرک میکند. هر چه طراحی تمیزتر و روبهروتر، حرکت لب پایدارتر.
امتحانش رایگان است؟
+
بله. اعتبار رایگان چک-این روزانه (۶ تا ۱۲ در روز، تا ۶۰ در هفته) برای چند نگاه آزمایشی کوتاه کافی است. کارت اعتباری لازم نیست.