फोटो से बोलता अवतार: हर फोटो को आवाज़ मिलती है
वीडियो बनाने की सबसे बड़ी बाधा कैमरा है। बोलता अवतार उसे खत्म करता है: एक पोर्ट्रेट अपलोड करें, एक वॉइस क्लिप जोड़ें और AI होंठों को ऑडियो के अनुसार हिलाता है — स्वाभाविक पलकें, सिर की हरकत। अब आपको कभी कैमरे के सामने खड़ा होने की ज़रूरत नहीं।
रेफरेंस-आधारित दृष्टिकोण तर्क उलट देता है। आप मॉडल को दिखाते हैं कि किसका चेहरा एनिमेट करना है (आपका पोर्ट्रेट, मैस्कॉट, प्रेज़ेंटर) और कौन सी आवाज़ इस्तेमाल करनी है (वॉइस रेफरेंस क्लिप)। मॉडल बोलने की हरकत को लॉक किए गए चेहरे पर लगाता है, नया व्यक्ति गढ़ता नहीं।
आज़माएं: बोलता अवतार जनरेटर
Google से 1 सेकंड में लॉग इन करें — रोज़ाना चेक-इन करें, फ्री क्रेडिट पाएं (हफ़्ते में अधिकतम 60)फ्री में ये सब →
प्रमुख डेमो और प्रॉम्प्ट उदाहरण
ऊपर दिए गए जनरेटर को अपने-आप भरने के लिए «इस प्रॉम्प्ट से बनाएं» पर क्लिक करें
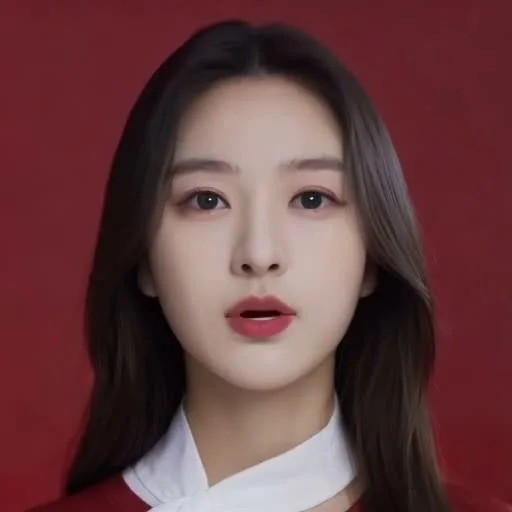
ई-कॉमर्स प्रोडक्ट प्रेज़ेंटर
एक पेशेवर महिला प्रेज़ेंटर सीधे कैमरे की ओर देखकर प्रोडक्ट के बारे में बता रही है, स्वाभाविक पलकें, हल्की सिर की हरकत, गर्म स्टूडियो लाइट
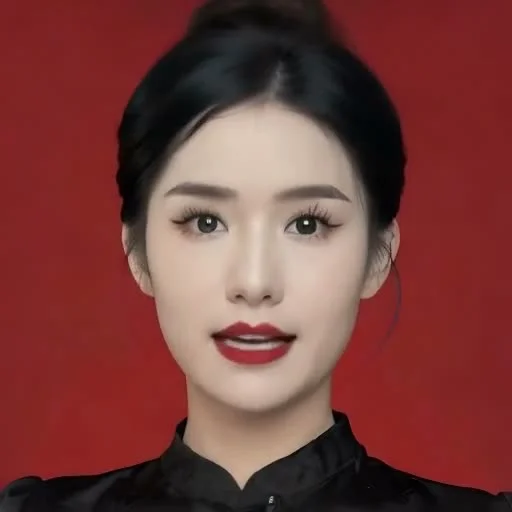
ब्रांड कीनोट और इवेंट होस्ट
माइक पकड़े एक एलिगेंट होस्ट कैमरे के सामने ब्रांड विज़न प्रस्तुत कर रही है, आत्मविश्वास भरी मुस्कान, स्वाभाविक आई कॉन्टैक्ट और लिप-सिंक
बोलते अवतार क्यों काम करते हैं (फोटो + आवाज़ वीडियो कैसे बनता है)
क्रिएटर्स के वीडियो न पोस्ट करने का नंबर एक कारण कैमरा है। लेंस के सामने, स्क्रिप्ट याद करना, फिर से रिकॉर्ड करना — घंटों की मेहनत। स्टॉक अवतार कैमरे की समस्या हल करते हैं, लेकिन चेहरा सामान्य और आवाज़ आपकी नहीं होती।
रेफरेंस-आधारित दृष्टिकोण तर्क उलट देता है। आप मॉडल को दिखाते हैं कि किसका चेहरा एनिमेट करना है (आपका पोर्ट्रेट, मैस्कॉट, प्रेज़ेंटर) और कौन सी आवाज़ इस्तेमाल करनी है (वॉइस रेफरेंस क्लिप)। मॉडल बोलने की हरकत को लॉक किए गए चेहरे पर लगाता है, नया व्यक्ति गढ़ता नहीं।
यह लाइव कॉमर्स, कोर्स नरेशन और मल्टीलिंगुअल चैनलों का मानक वर्कफ़्लो है: एक पोर्ट्रेट जो नहीं बदलता, हर भाषा के लिए एक ऑडियो क्लिप — वही प्रेज़ेंटर दोबारा रिकॉर्डिंग के बिना दस भाषाएँ बोलता है।
Sesshu में बोलते अवतार का वीडियो बनाने के 4 चरण
- STEP 011 / 4
एक साफ पोर्ट्रेट तैयार करें
पूरा चेहरा दिखाने वाली सामने की एक तस्वीर — सेल्फी, AI पोर्ट्रेट या मैस्कॉट। हर प्रेज़ेंटर के लिए एक फोटो।
- STEP 022 / 4
फोटो को रेफरेंस के रूप में जोड़ें
नीचे दिए गए जनरेटर में (या /reference-to-video पर) पोर्ट्रेट को रेफरेंस पैनल में लोड करें।
- STEP 033 / 4
आवाज़ जोड़ें और स्क्रिप्ट लिखें
एक छोटा वॉइस क्लिप रेफरेंस के रूप में जोड़ें (Kling 4.0 इसे बोलने वाले की आवाज़ मानता है) और प्रॉम्प्ट को अंदाज़ पर केंद्रित रखें — 'कैमरे से गर्मजोशी से बात करता है, स्वाभाविक पलकें'।
- STEP 044 / 4
जनरेट करें और प्रस्तुति जांचें
पहले एक छोटा टेक बनाएं, होंठ और गति जांचें, स्क्रिप्ट या रोशनी सुधारें, फिर अंतिम दृश्य एक साथ बनाएं।
बोलते अवतार से जुड़े अक्सर पूछे जाने वाले सवाल
क्या एक फोटो सच में बोलने वाला वीडियो बन जाती है?
+
हाँ। पोर्ट्रेट रेफरेंस के रूप में, ऑडियो क्लिप आवाज़ के रूप में — मॉडल बोलने के अनुसार होंठ और सिर ढालता है। Sesshu यह Kling 4.0 के वॉइस रेफरेंस वर्कफ़्लो से देता है।
कौन से ऑडियो इस्तेमाल किए जा सकते हैं?
+
छोटा MP3/WAV क्लिप काफी है: नरेशन, एक संवाद या अपनी रिकॉर्डिंग। हर क्लिप लगभग 15 सेकंड, सबसे साफ परिणाम के लिए शांत कमरे में रिकॉर्ड करें।
क्या मैस्कॉट या कार्टून किरदारों पर भी चलता है?
+
हाँ — वही रेफरेंस वर्कफ़्लो मैस्कॉट, एनीमे किरदार और प्रोडक्ट ब्रांड एंबेसडर को बोलने लगाता है। डिज़ाइन जितना साफ और सामने का हो, होंठ उतने स्थिर।
क्या मुफ्त में आज़मा सकते हैं?
+
हाँ। दैनिक चेक-इन के मुफ्त क्रेडिट (रोज़ 6–12, हफ्ते में 60 तक) कई छोटे टेस्ट टेक के लिए काफी हैं। क्रेडिट कार्ड की ज़रूरत नहीं।